AI kijkt nauwkeuriger na dan een docent
Een analyse van 20.000 beoordelingen: waarom de kwaliteit van het correctievoorschrift bepalend is voor het succes van AI in het onderwijs.
Generatieve Kunstmatige Intelligentie (Gen AI) belooft de werkdruk van docenten drastisch te verlagen, met name bij het meest tijdrovende onderdeel van het vak: het nakijken van open vragen. Maar hoe nauwkeurig is een Large Language Model (LLM) vergeleken met het menselijk oordeel? En wat zijn de factoren die deze nauwkeurigheid bepalen?
Om dit te onderzoeken analyseerde ToetsPers 20.000 beoordelingen van docenten en vergeleek deze met scores van onze eigen AI-nakijkmodule.
De uitkomst is opvallend: in 80% van de gevallen voorspelt AI exact dezelfde score als de docent. Maar waar de scores uiteenlopen, blijkt de AI vaak ‘nauwkeuriger’ in het strikt volgen van de regels, terwijl de docent vaker context en niveau meeweegt. De echte bottleneck voor AI in het onderwijs blijkt niet de modeltechnologie te zijn, maar de kwaliteit en reproduceerbaarheid van het correctievoorschrift.
De dataset en onderzoeksopzet
In het kader van de Europese AI-Act (die toetssystemen indeelt in hoog-risicosystemen) is het vereist om de accuratie van AI-systemen objectief in kaart te brengen. We definieerden accuratie als de mate waarin de score van het AI-thinking model exact overeenkomt met de score die de docent toekende.
De dataset bestaat uit 20.000 door docenten beoordeelde antwoorden op open vragen aan de hand van een correctievoorschrift (CV). De vragen bestrijken bèta-, gamma- en alfavakken en talen. De te behalen scores varieerden van 1 tot 12 punten, waarbij het zwaartepunt lag tussen de 1 en 3 punten.
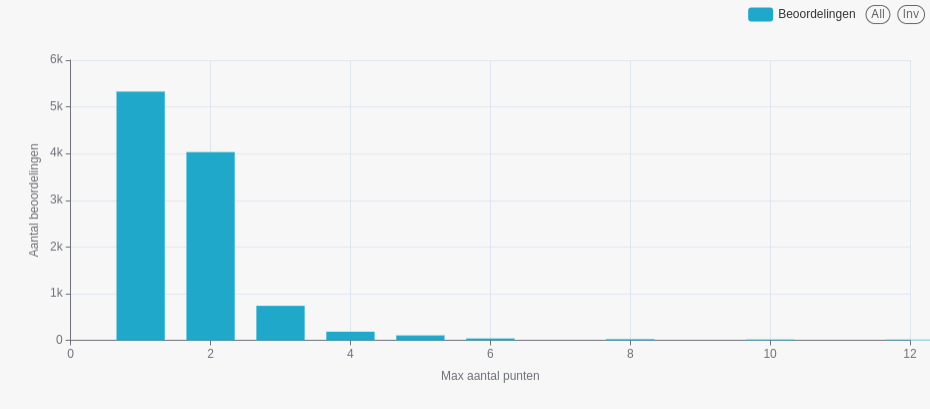
Staafdiagram met de verdeling van het aantal beoordelingen ten opzichte van het maximaal te behalen aantal punten (1 t/m 12 punten).
Uit alle afwijkende beoordelingen is vervolgens een steekproef van 150 resultaten getrokken. Deze zijn onderworpen aan een audit door een onafhankelijke tweede menselijke beoordelaar, waarbij ook is vastgesteld of het correctievoorschrift toereikend was om het antwoord eenduidig te kunnen beoordelen.
De basiscijfers: 80% overeenkomst
Uit de data blijkt een sterke correlatie tussen het oordeel van de AI en dat van de docent:
- 80% Overeenkomst: In 4 van de 5 gevallen kent de AI exact hetzelfde aantal punten toe als de docent.
- 20% Afwijking: Waar de scores afwijken, is de verdeling als volgt:
- 13%: AI is strikter dan de docent.
- 7%: AI is coulanter dan de docent.
AI neigt er dus sneller toe strenger te zijn dan de menselijke beoordelaar.
Zekerheid in extremen
Een belangrijk inzicht voor de praktijk is hoe de accuratie verdeeld is over het type scores:
- Volledige score: Kent de AI het maximale aantal punten toe? Dan is de docent het daar in 90% van de gevallen mee eens.
- Nul score: Kent de AI nul punten toe? Dan is de docent het in 78% van de gevallen mee eens.
- Deelscores: Zodra een vraag gedeeltelijk goed is en er deelpunten worden toegekend, daalt de accuratie naar ~61%.
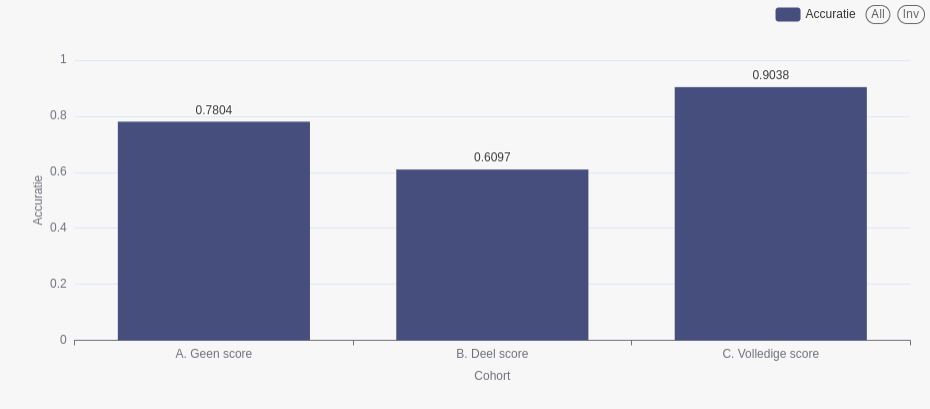
Staafdiagram met de accuratie per score-categorie (Geen score: 78,0%, Deelscore: 61,0%, Volledige score: 90,4%).
Daarnaast zien we een duidelijke negatieve correlatie met de omvang van de vraag: hoe meer punten er voor een open vraag te verdienen zijn, hoe lager de overeenkomst tussen AI en docent.
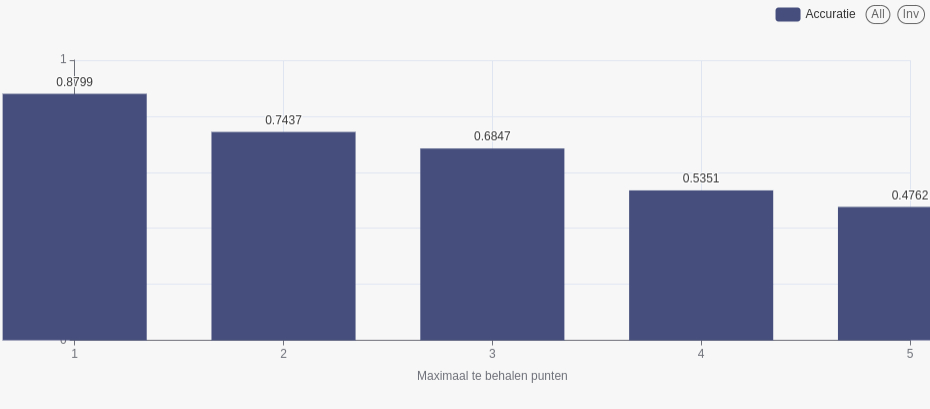
Staafdiagram dat toont hoe de accuratie afneemt naarmate het maximaal te behalen punten toeneemt (van 88% bij 1 punt naar 48% bij 5+ punten).
De kern van het probleem: het correctievoorschrift
Waarom presteert AI zo trefzeker bij 0 of maximale punten, maar zakt de accuratie in bij deelscores en grotere vragen? Het antwoord ligt in het correctievoorschrift (CV).
Een goed correctievoorschrift moet functioneren als een reproduceerbaar experiment: verschillende beoordelaars — mens of machine — zouden op basis van dezelfde instructie tot exact dezelfde score moeten komen. In de praktijk blijkt dit zelden het geval.
Waar het wringt: reproduceerbaarheid
Docenten nemen tijdens het nakijken bewust en onbewust veel extra context mee:
- Het niveau van de klas en eerdere prestaties;
- Hoe de lesstof in de les behandeld is;
- Antwoorden die de leerling eerder in de toets gaf.
Een AI doet dit niet. Een model kijkt uitsluitend naar de tekst van het correctievoorschrift en het antwoord van de leerling. Wanneer het CV niet compleet, ambigu of te beknopt is, ontstaan er direct afwijkingen.
Voorbeeld: een zwak correctievoorschrift
Vraag: Wat is de meest gebruikte maatsoort in popmuziek? Leg ook uit wat de eigenschap van deze maat is in relatie tot muzieknoten.
CV:4/4 + uitleg (Max score: 2)
Het probleem: Het is onduidelijk hoe de punten verdeeld worden. Krijgt de leerling 1 punt voor “4/4” en 1 punt voor de uitleg? Welke specifieke elementen moeten in de uitleg terugkomen? De docent weet intuïtief welke eisen hij stelt, maar voor de AI ontbreekt elk houvast.
Voorbeeld: een verbeterd correctievoorschrift
Verbeterd CV:
4/4ofvierkwartsmaatof een andere juiste benaming van de maat (1 punt)- Uitleg waaruit blijkt dat de leerling begrijpt dat er 4 kwartnoten in een maat passen (1 punt)
Max score: 2
In dit tweede voorbeeld zijn de criteria expliciet en is de deelpuntenverdeling helder. Hierdoor stijgt de accuratie van het model meteen aanzienlijk.
Waarom AI “nauwkeuriger” nakijkt, maar de docent vaak “beter”
Uit de audit van de 20% afwijkende gevallen kwamen twee cruciale inzichten naar voren:
1. Het ontoereikende correctievoorschrift (64% van de afwijkingen)
In bijna twee derde van de gevallen waarin AI en docent verschilden, bleek het correctievoorschrift ontoereikend of te vaag. De AI hield zich strikt aan de letter van het voorschrift, terwijl de docent coulance toepaste om de leerling een ‘eerlijkere’ score te geven.
Conclusie: De docent kijkt hier menselijker en rechtvaardiger na, maar de AI kijkt formeel gezien nauwkeuriger volgens de regels van het voorschrift.
2. De scherpere nakijker (36% van de afwijkingen)
Bij de overige afwijkingen, waar het correctievoorschrift wél helder en compleet was, bleek de AI vaker de juiste score te hebben toegekend dan de docent:
- In 26% van de gevallen had de AI volgens de audit gelijk;
- In slechts 10% van de gevallen had de docent gelijk.
Docenten maakten bij repeterend nakijkwerk regelmatig fouten door vermoeidheid of afnemende concentratie (zoals het per ongeluk omwisselen van ‘juist’ en ‘onjuist’). AI behoudt daarentegen constante scherpte van de eerste tot de dertigste leerling.
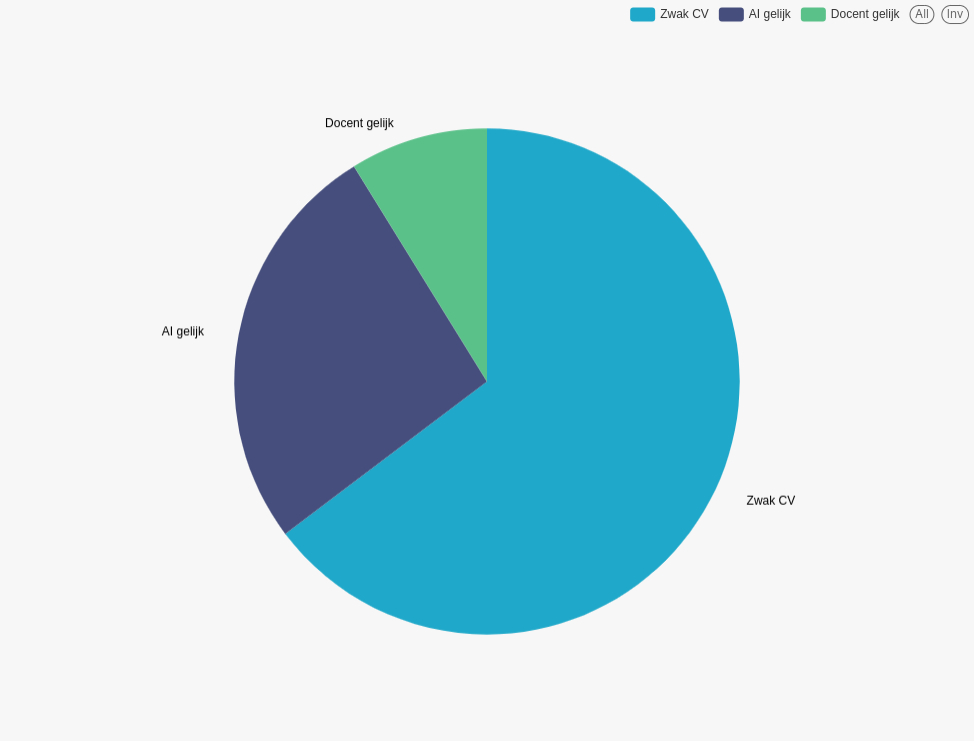
Cirkeldiagram van de afwijkingen (20% van alle beoordelingen), verdeeld in ‘Zwak CV’ (64%), ‘AI gelijk’ (26%) en ‘Docent gelijk’ (10%).
Wat betekent dit voor de toekomst van toetsing?
De uitspraak “AI kijkt nauwkeuriger na dan een docent” klopt technisch, maar behoeft nuance: zolang correctievoorschriften waterdicht zijn, is AI consistenter en minder foutgevoelig dan de mens. Zijn de voorschriften vaag? Dan wint de docent dankzij menselijke context en inlevingsvermogen.
Voor de praktijk in het voortgezet onderwijs levert dit drie concrete richtlijnen op:
1. Investeren in de toetsconstructie
Het formuleren van eenduidige, heldere correctievoorschriften verhoogt niet alleen de betrouwbaarheid van AI, maar verbetert de algehele toetskwaliteit binnen de school. In ToetsPers zetten we daarom AI juist in aan de voorkant: om docenten te helpen bij het formuleren van complete, meerledige correctievoorschriften.
2. Slimme, hybride workflows
We hoeven het nakijkproces niet binair te benaderen (alles handmatig óf alles automatisch):
- Automatiseren: Geeft AI 0 punten of de volle score? Dan is de betrouwbaarheid 78% tot 90%. Dit kan na een korte steekproef direct worden overgenomen.
- Menselijke controle: Geeft AI een deelscore of is de vraag meer dan 3 punten waard? Dán vraagt het systeem de docent om gerichte verificatie.
3. Sluit de kwaliteitscirkel (Close the loop)
Door toetsresultaten na afloop te analyseren met psychometrische gegevens (zoals p-, rit- en rir-waarden), worden afwijkende vragen en onduidelijke antwoordmodellen direct zichtbaar. Zo verbeteren docenten hun opgavenbank en antwoordmodellen continu voor de volgende toetsperiode.
Door inzichtelijk te maken wanneer een docent moet ingrijpen, verandert nakijken van een tijdrovende sleurtaak in een doelgerichte kwaliteitscontrole.